在深度学习的发展历程中,注意力机制(Attention Mechanism)无疑是近十年来最具影响力的技术突破之一。它不仅重塑了自然语言处理的格局,还逐步渗透到计算机视觉、强化学习、信息检索乃至无人机仿真等多个领域。对于希望系统掌握深度学习入门的开发者来说,理解注意力机制的原理与演化路径,已经成为绕不开的一课。本文将从基本概念出发,结合Transformer注意力机制、元学习算法、信息检索技术、Fast.ai教程、AirSim仿真与强化学习等关键词,梳理注意力机制的知识体系与工程实践要点。
注意力机制到底是什么:从"看全局"到"抓重点"
传统神经网络在处理序列数据时,往往需要把整段输入压缩成一个固定长度的向量,这在长文本或高维图像场景下容易造成信息丢失。注意力机制的核心思想很朴素:让模型在处理某个位置时,能够动态地为输入的不同部分分配权重,把"注意力"集中在最相关的信息上。
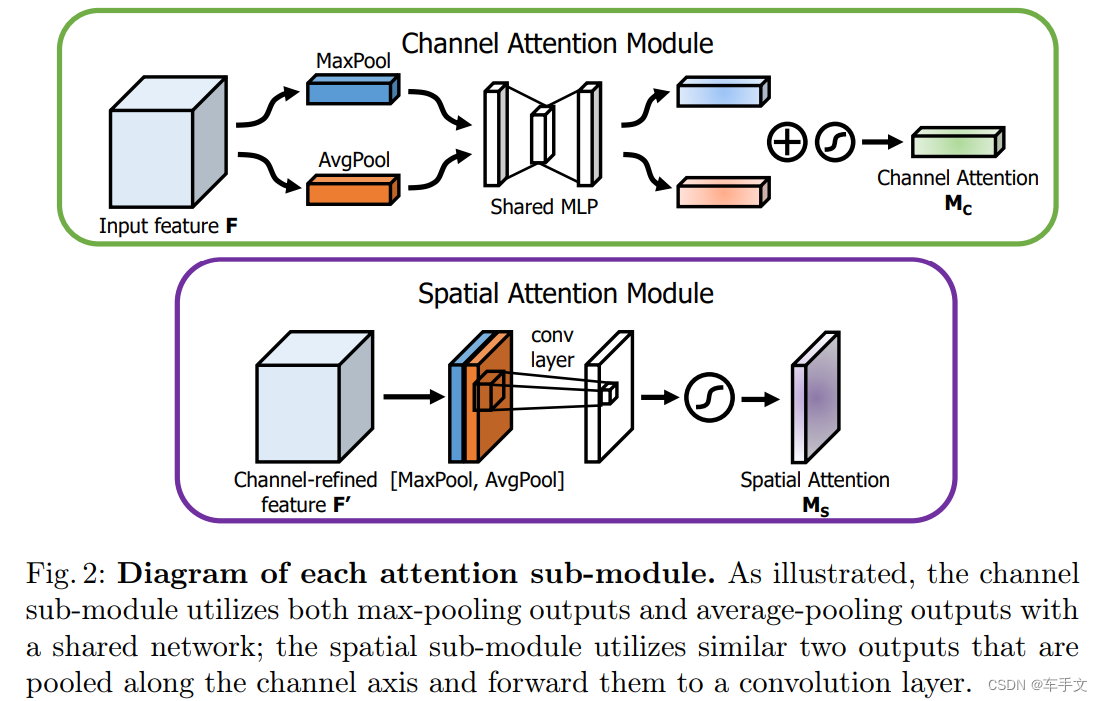
可以用一个直观的类比来理解:当你在嘈杂的咖啡馆里与朋友交谈时,耳朵接收的是全部声音,但大脑会自动过滤背景噪声,聚焦于对方的话语。注意力机制做的正是类似的事情——通过计算查询(Query)与键(Key)的相似度,得到一组权重,再对值(Value)加权求和。
- 查询、键、值三要素:Query 代表当前关注的目标,Key 代表可被检索的信息索引,Value 则是实际被聚合的内容。
- 缩放点积注意力:通过点积计算相似度并除以维度平方根,避免梯度消失,是Transformer的基础组件。
- 多头注意力:并行运行多组注意力,让模型从不同子空间捕捉语义关系,提升表达能力。
理解这三个层次,基本就掌握了注意力机制的骨架。对于刚接触计算机科学基础的读者,建议先用小规模矩阵手算一遍注意力权重,再进入框架实现,理解会更扎实。
Transformer注意力机制:并行化带来的范式转移
2017年提出的Transformer架构,彻底放弃了循环结构,完全依赖注意力机制建模序列依赖。这一设计带来了两个关键优势:一是训练可以高度并行化,充分利用GPU算力;二是任意两个位置之间的路径长度恒为1,长距离依赖建模能力显著增强。
Transformer注意力机制的标准结构包括编码器与解码器两大部分,其中自注意力(Self-Attention)让序列内部元素互相"看见",交叉注意力(Cross-Attention)则让解码器关注编码器输出。工程实践中,有几个细节值得特别注意:
- 位置编码:注意力本身不感知顺序,必须通过正弦位置编码或可学习位置嵌入补足序列信息。
- 残差连接与层归一化:保证深层网络训练稳定,是Transformer能够堆叠数十层的前提。
- 掩码机制:解码器使用因果掩码防止"看到未来",这是自回归生成任务的关键。
如今,Transformer已经衍生出BERT、GPT、ViT等众多变体,成为大模型时代的基石。对于从事软件开发与系统集成的团队而言,掌握Transformer注意力机制的推理优化技巧,例如KV缓存、稀疏注意力、FlashAttention,直接关系到线上服务的延迟与成本。
注意力机制与元学习算法的结合
元学习算法关注的是"学会学习",即让模型在少量样本上快速适应新任务。注意力机制在元学习中扮演了重要角色:它可以看作一种可微的检索过程,模型根据当前任务上下文,从支持集(Support Set)中动态提取有用信息。
典型的结合方式包括:
- 注意力增强的记忆网络:通过注意力读写外部记忆矩阵,实现跨任务的知识复用。
- 任务条件化注意力:根据任务嵌入调整注意力权重,使模型在不同任务间平滑切换。
- 原型网络与注意力度量:用注意力替代欧氏距离,提升少样本分类的鲁棒性。
在信息传输与大数据服务场景中,元学习加注意力的组合特别适合处理"冷启动"问题,例如新用户推荐、新设备故障诊断等任务,能够在数据稀缺时依然保持可用的精度。
信息检索技术中的注意力应用
信息检索技术是注意力机制最早落地的领域之一。传统检索依赖词频与倒排索引,而基于注意力的神经检索模型能够捕捉查询与文档之间的语义匹配关系。常见做法包括:
- 查询-文档交互注意力:对查询词与文档词两两计算注意力,构建细粒度匹配矩阵。
- 稠密向量检索:用双塔结构将查询与文档编码为向量,通过近似最近邻搜索实现毫秒级召回。
- 重排序阶段:交叉注意力模型对候选集精排,兼顾效果与效率。
在企业级搜索、知识库问答、日志分析等场景中,这套技术栈已经被广泛采用。结合云计算平台提供的向量数据库服务,团队可以较快搭建起可用的语义检索系统,这也是信息技术服务中增长较快的需求方向。
实战路径:Fast.ai教程、AirSim仿真与强化学习
理论之外,动手实践是巩固注意力机制认知的最佳方式。对于希望快速上手的开发者,Fast.ai教程提供了自顶向下的学习路径,先跑通完整项目再深入原理,非常适合深度学习入门者。建议的学习顺序如下:
- 先用Fast.ai教程完成一个文本分类或图像分类项目,建立整体直觉;
- 再手动实现一个缩放点积注意力模块,对照框架源码理解细节;
- 最后在真实任务中调参,观察注意力权重分布是否符合预期。
在强化学习与机器人领域,注意力机制同样大有可为。以AirSim仿真为例,无人机仿真平台可以生成带有多模态观测的数据,智能体需要从图像、激光雷达、惯性测量单元等异构输入中提取关键信息。引入注意力模块后,策略网络能够自动聚焦于障碍物、目标点等关键区域,显著提升样本效率与飞行安全性。这类"仿真训练、真机部署"的流程,正是当前智能无人系统研发的主流范式,也带动了仿真平台、算力调度、模型运维等一系列信息技术服务需求。
常见误区与工程建议
注意力机制虽然强大,但在实际落地中仍有一些容易踩的坑:
- 盲目堆叠注意力层:层数增加并不必然带来收益,需结合数据规模与任务复杂度评估。
- 忽视计算复杂度:标准自注意力复杂度随序列长度平方增长,长序列场景应优先考虑稀疏或线性注意力变体。
- 忽略可解释性:注意力权重不等于因果解释,用于风控、医疗等敏感场景时需谨慎解读。
- 训练数据质量:注意力机制对噪声敏感,数据清洗与去偏往往比模型结构更能决定最终效果。
从工程角度看,建议团队在系统集成阶段就把推理性能、显存占用、批处理策略纳入设计,避免模型上线后才发现延迟不可接受。同时,建立完善的监控与运维体系,跟踪注意力分布漂移,有助于及早发现数据分布变化带来的性能退化。
结语
注意力机制从最初的一个小技巧,发展为支撑大模型的核心架构,其影响力已经远超自然语言处理范畴。无论是Transformer注意力机制的工程优化、元学习算法的任务适配,还是信息检索技术中的语义匹配、AirSim仿真与强化学习中的感知决策,注意力都扮演着"信息筛选器"的角色。对于身处信息传输、软件与信息技术服务业的从业者而言,系统掌握注意力机制,既是理解现代深度学习入门知识的钥匙,也是构建高质量智能应用的基础能力。建议读者结合Fast.ai教程动手实践,在真实项目中反复验证,让理论真正转化为可交付的技术服务能力。