在深度学习快速发展的今天,注意力机制(Attention Mechanism)已经成为推动人工智能技术进步的关键力量。从自然语言处理到计算机视觉,从强化学习到无人机仿真,注意力机制正在重塑我们理解和构建智能系统的方式。本文将深入探讨注意力机制的核心原理、技术演进路径以及在实际工程中的落地实践,为从事信息传输、软件和信息技术服务的开发者提供系统性的技术参考。
注意力机制的本质:让模型学会"选择性关注"
注意力机制的核心思想源于人类认知系统的一个重要特性——我们并不会对接收到的所有信息给予同等程度的处理,而是会有选择地将注意力集中在与当前任务最相关的部分。在深度学习领域,这一思想被转化为一种可计算的权重分配机制。
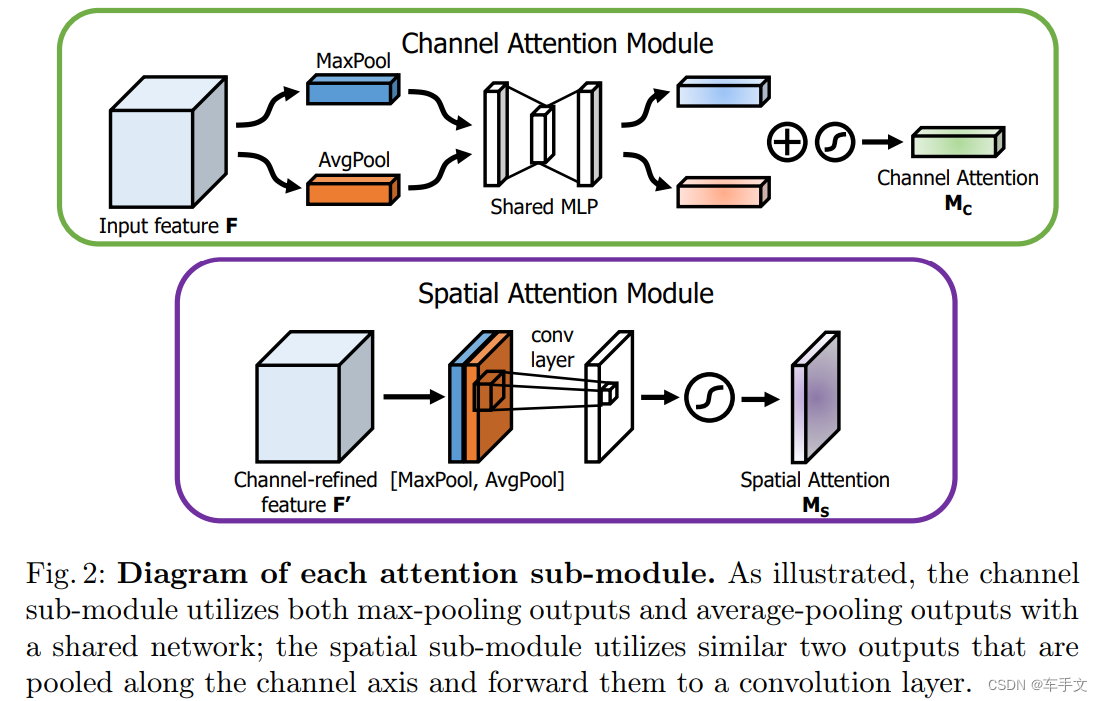
传统的神经网络在处理输入信息时,往往采用"一视同仁"的方式,每个输入元素对输出的贡献是固定的或由网络参数隐式决定的。而注意力机制则显式地计算每个输入元素的重要性权重,使模型能够动态地聚焦于关键信息。这种机制带来了三个显著优势:
- 动态适应性:权重根据输入内容实时计算,而非固定不变,使模型能够灵活应对不同的输入模式。
- 可解释性增强:注意力权重提供了直观的"关注热图",帮助研究人员理解模型的决策依据。
- 长距离依赖建模:相比循环神经网络逐步传递信息的方式,注意力机制可以直接建立任意两个位置之间的关联。
从数学形式上看,经典的缩放点积注意力(Scaled Dot-Product Attention)通过查询向量(Query)与键向量(Key)的点积计算相似度,再经Softmax归一化得到注意力权重,最终对值向量(Value)进行加权求和。这一简洁而优雅的公式,构成了Transformer架构的基石。
Transformer注意力机制:架构革命与工程实践
2017年,Google团队发表的《Attention Is All You Need》论文彻底改变了序列建模的范式。Transformer架构完全摒弃了循环和卷积结构,纯粹依靠注意力机制来捕获输入序列中的依赖关系。这一设计不仅在翻译任务上取得了突破性表现,更催生了BERT、GPT系列等一大批具有深远影响力的模型。
Transformer中的多头注意力(Multi-Head Attention)机制是其成功的关键设计之一。通过将查询、键、值向量投影到多个子空间中并行计算注意力,模型能够同时从不同角度捕获信息——有的头关注局部语法关系,有的头关注语义相似性,有的头则捕捉长距离的指代关系。这种"多视角"的设计显著提升了模型的表达能力。
在实际工程中,Transformer注意力机制的高效实现涉及多项优化技术:
- KV缓存机制:在自回归生成任务中缓存已计算的键值对,避免重复计算,大幅提升推理效率。
- 稀疏注意力:通过限制注意力范围(如滑动窗口注意力、局部敏感哈希注意力)将复杂度从O(n²)降至O(n log n)甚至O(n)。
- Flash Attention:利用GPU内存层次结构优化注意力计算的IO效率,在保持数值精度的同时实现数倍加速。
- 分组查询注意力(GQA):在多头注意力和多查询注意力之间取得平衡,减少推理时的内存占用。
对于从事系统集成和软件开发的团队而言,理解这些优化技术对于构建高性能的AI应用至关重要。在实际项目中,需要根据具体场景的序列长度、批量大小和延迟要求,选择合适的注意力变体。
注意力机制与元学习算法的融合
元学习(Meta-Learning)旨在让模型"学会学习",即通过少量样本快速适应新任务。注意力机制在元学习算法中扮演着越来越重要的角色,两者的结合产生了多个有价值的研究方向。
在基于度量的元学习方法中,注意力机制被用于计算查询样本与支持集样本之间的相似度权重,从而实现更精准的分类决策。例如,在少样本图像分类任务中,模型可以通过注意力机制自动识别支持集中与查询样本最相关的特征维度,而非简单地使用全局特征距离。
另一方面,元学习也可以反过来优化注意力机制本身。通过学习如何在不同任务间快速调整注意力分布,模型能够在面对新领域数据时更快地收敛。这种"元注意力"的思路在跨领域信息检索和自适应推荐系统中具有广阔的应用前景。
在信息检索技术领域,注意力机制与元学习的结合同样展现出独特价值。传统检索模型依赖固定的特征匹配策略,而引入注意力机制后,系统能够根据查询意图动态调整不同特征维度的权重;元学习则进一步赋予系统快速适应新查询模式的能力,显著提升检索系统的泛化性能。
注意力机制在强化学习与仿真平台中的应用
强化学习领域同样受益于注意力机制的引入。在复杂环境中,智能体面临的状态空间往往维度极高且包含大量冗余信息,注意力机制帮助智能体聚焦于与决策最相关的状态特征。
在无人机仿真平台AirSim中,基于注意力机制的强化学习策略展现出了优异的性能。无人机在复杂三维环境中需要同时处理视觉感知、姿态估计和避障决策等多模态信息,注意力机制使策略网络能够动态权衡不同传感器输入的贡献。例如,在密集障碍物环境中,视觉注意力更多地集中在近处障碍物上;而在开阔空域中,则更关注远距离的目标位置信息。
对于使用Fast.ai等深度学习框架的开发者而言,注意力机制的实现已经变得相当便捷。Fast.ai教程中涵盖了从基础注意力到Transformer的渐进式教学内容,配合AirSim仿真平台,开发者可以在虚拟环境中快速验证注意力增强的强化学习算法,大幅降低实验门槛和硬件成本。
值得注意的是,在仿真到现实的迁移(Sim-to-Real)过程中,注意力机制的可解释性提供了额外的调试手段。通过可视化注意力分布,工程师可以判断策略网络是否关注到了正确的环境特征,从而有针对性地调整仿真参数或网络结构。
计算机科学基础视角下的注意力机制学习路径
对于希望系统掌握注意力机制的开发者,建议遵循一条从基础到进阶的学习路径:
- 数学基础:线性代数中的向量空间与矩阵运算、概率论中的条件概率与Softmax函数,是理解注意力机制的前提。
- 深度学习入门:掌握神经网络的基本结构、反向传播算法和优化方法,推荐通过Fast.ai教程的实践课程建立直觉理解。
- 序列建模:从RNN/LSTM的局限性出发,理解注意力机制为何能够解决长距离依赖问题。
- Transformer深入:精读原始论文,动手实现一个简化版的Transformer,理解多头注意力、位置编码和残差连接的设计细节。
- 领域应用:结合自身业务场景(如信息检索、推荐系统、仿真控制),探索注意力机制的适配与优化方案。
在信息传输和信息技术服务行业中,注意力机制的应用已经超越了学术研究范畴,正在实际产品中发挥价值。无论是智能客服中的意图理解、大数据分析中的特征选择,还是云计算平台中的资源调度优化,注意力机制都提供了一种优雅而有效的技术手段。创智数据科技持续关注这一领域的技术演进,致力于将前沿算法与工程实践相结合,为行业客户提供高质量的软件开发与系统集成服务。
结语
注意力机制从最初作为序列到序列模型的辅助组件,发展到今天成为深度学习基础设施的核心构件,其演进历程充分体现了"简单而通用"的设计哲学的力量。随着稀疏注意力、线性注意力等高效变体的不断成熟,以及注意力机制与元学习、强化学习等范式的深度融合,我们有理由相信,这一技术将在更广泛的场景中释放潜力。对于技术团队而言,深入理解注意力机制的原理与工程实践,是构建下一代智能系统的必要功课。