在信息传输、软件和信息技术服务业高速迭代的今天,人工智能已经从实验室走向工程现场。无论是互联网平台的大数据处理、云计算基础设施调度,还是系统集成与智能运维,背后都离不开一套高效的模型架构支撑。而在众多深度学习技术中,注意力机制(Attention Mechanism)无疑是最具革命性的突破之一。它让模型学会"有选择地关注",从而在信息检索、自然语言处理、计算机视觉乃至无人机仿真等领域展现出强大能力。本文将从原理、变体、工程实践到行业应用,系统梳理注意力机制的知识脉络,帮助开发者建立完整的认知框架。
一、注意力机制的本质:让模型学会"分配注意力"
传统神经网络在处理序列数据时,往往把输入信息一视同仁地压缩成固定长度的向量表示,这就像让人在嘈杂环境中同时听清所有人的说话——信息过载且效率低下。注意力机制的核心思想,是引入一组可学习的权重,让模型根据当前任务动态决定"看哪里、看多少"。
从数学形式上看,注意力机制通常包含三个要素:查询(Query)、键(Key)和值(Value)。模型通过计算查询与各个键的相似度得到注意力分数,经归一化后作为权重对值进行加权求和。这一过程可以概括为"用查询去检索最相关的信息",恰好与信息检索技术的底层逻辑高度一致——这也是注意力机制在搜索引擎、推荐系统中被广泛采用的原因。
对于刚接触深度学习入门的开发者而言,理解注意力机制不必一开始就陷入公式推导。可以先从直观类比入手:阅读一段长文时,人眼会自然聚焦于关键句子;注意力机制做的就是让神经网络具备这种"聚焦"能力。掌握这一直觉后,再回过头看缩放点积注意力、加性注意力等具体形式,会顺畅得多。
二、Transformer注意力机制:架构革命的中枢
2017年提出的Transformer架构,把注意力机制推向了舞台中央。它彻底抛弃了循环结构,完全依赖自注意力(Self-Attention)来建模序列内部的长距离依赖关系。这一设计带来了两个直接好处:一是并行计算效率大幅提升,二是对长序列的建模能力显著增强。
自注意力与多头注意力
自注意力让序列中的每个位置都能与所有其他位置交互,从而捕捉全局上下文。而多头注意力(Multi-Head Attention)则进一步把注意力拆分成多个"头",每个头在不同的表示子空间中学习不同的关注模式。可以把它理解为多个专家从不同角度审视同一份数据,最后汇总意见,模型的表达能力因此成倍提升。
位置编码与残差连接
由于Transformer不再具备天然的序列顺序信息,位置编码(Positional Encoding)成为必要补充。配合残差连接与层归一化,深层Transformer才能稳定训练。这些工程细节看似琐碎,却是模型能否在真实业务中落地的关键。在软件开发与系统集成项目中,团队往往会基于开源Transformer实现进行二次优化,此时对这些组件的理解深度直接决定了调优效率。
三、注意力机制的家族扩展:从软注意力到稀疏注意力
随着应用场景的多样化,注意力机制衍生出丰富的变体,开发者需要根据任务特点选择合适的方案:
- 软注意力与硬注意力:软注意力对所有位置分配连续权重,可微且易于训练;硬注意力则做离散选择,计算更省但需要强化学习等策略进行训练。
- 稀疏注意力:面对超长序列,全连接的注意力计算量呈平方级增长。稀疏注意力通过限制关注范围,在保证效果的同时大幅降低显存与算力开销,适合大数据场景下的长文本处理。
- 交叉注意力:常用于编码器-解码器结构,让解码端动态查询编码端信息,是多模态任务中的常见组件。
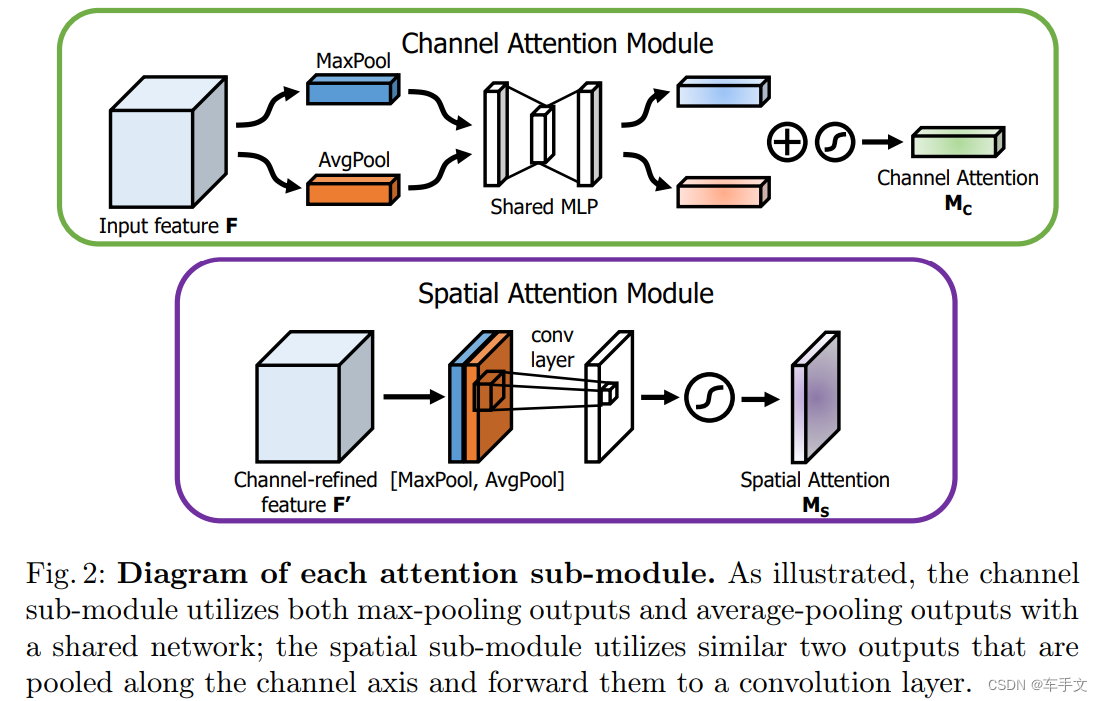
- 通道注意力与空间注意力:在计算机视觉中,前者关注"哪些特征通道更重要",后者关注"图像哪些区域更重要",二者结合可显著提升检测与分割精度。
值得注意的是,注意力机制与元学习算法的结合正成为研究热点。元学习强调"学会学习",而注意力机制提供了快速适配新任务的信息筛选手段,二者结合后在少样本分类、快速适应等场景中表现亮眼。对于从事人工智能技术服务的企业来说,这类前沿组合是构建差异化竞争力的重要方向。
四、工程实践:用Fast.ai教程快速上手注意力模型
理论理解之后,动手实践是巩固认知的最佳路径。Fast.ai教程以"自顶向下"的教学理念著称,主张先跑通完整项目,再逐步深入底层原理,这与注意力机制的学习曲线非常契合。
建议的学习路径如下:
- 先用Fast.ai提供的高层API完成一个文本分类或翻译任务,观察模型结构中的注意力模块如何工作;
- 再逐步拆解Transformer Block的源码实现,理解多头注意力的张量维度变换;
- 最后尝试在自定义数据集上替换注意力变体,对比稀疏注意力与标准注意力的性能差异。
这种"先见森林、再见树木"的方式,能帮助开发者在较短时间内建立起对计算机科学基础中矩阵运算、梯度传播等概念的具象理解,避免陷入纯理论的泥潭。对于企业内部的深度学习入门培训,也可以借鉴这一思路设计课程体系。
五、注意力机制在强化学习与无人机仿真中的落地
注意力机制的价值不仅体现在自然语言处理。在强化学习领域,智能体面对高维观测输入时,需要从海量信息中提取决策相关线索。引入注意力机制后,智能体可以动态聚焦于关键状态特征,显著提升样本效率与策略稳定性。
在无人机仿真平台的建设中,这一优势尤为明显。AirSim仿真提供了逼真的物理环境与传感器数据,但视觉输入维度极高。通过在感知模块中嵌入注意力层,无人机可以更准确地识别障碍物、目标区域与飞行通道,从而在复杂环境中完成自主导航与避障任务。对于从事智能系统集成与运维的技术团队而言,掌握"仿真环境搭建 + 注意力模型训练 + 真实平台迁移"的完整链路,是承接低空经济相关项目的关键能力。
此外,注意力机制在信息检索技术中的应用同样值得关注。现代搜索引擎与推荐系统普遍采用基于Transformer的排序模型,通过注意力捕捉查询与文档之间的细粒度语义匹配,从而提升检索相关性。这与互联网平台的大数据分析和云计算资源调度形成了技术闭环。
六、面向行业的注意力机制应用建议
结合信息传输、软件和信息技术服务业的业务特点,企业在引入注意力机制时可参考以下建议:
- 场景优先:先明确业务痛点——是长文本理解、多模态检索还是时序预测,再选择对应的注意力变体,避免为用而用。
- 算力评估:标准注意力的平方复杂度对GPU资源要求较高,在云计算成本敏感的场景中,优先考虑稀疏化或分块计算方案。
- 可解释性:注意力权重本身具有一定的可解释价值,在安全运维、日志分析等场景中可作为辅助诊断依据。
- 持续迭代:注意力机制研究进展迅速,团队应保持对前沿论文与开源实现的跟踪,将新方法及时纳入技术选型评估。
从更宏观的视角看,注意力机制只是人工智能技术栈中的一环,但它所代表的"按需分配计算资源"的思想,正在深刻影响系统架构设计。无论是软件开发中的模块解耦,还是平台建设中的资源调度,都能从中获得启发。对于希望在大数据、云计算与人工智能融合浪潮中站稳脚跟的技术团队而言,深入理解并灵活运用注意力机制,是一项值得长期投入的基本功。
创智数据科技将持续关注注意力机制、Transformer架构、元学习算法与智能仿真等前沿方向,为开发者与行业客户提供有价值的技术内容与解决方案参考。